
Derniers Articles du monde de l'Intelligence Artificielle
07 octobre 2026
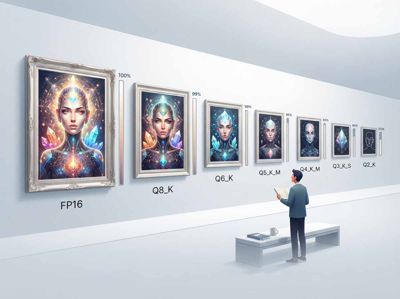
Guide des formats de quantification pour LLM locaux
Dans la parabole de Borges sur l'empire et sa carte, les cartographes finissent par dessiner une carte aussi grande que le territoire lui-même, pour découvrir qu'elle ne sert à rien. Un modèle linguistique en 16 bits est cette carte : parfaitement fidèle, à l'échelle 1:1, mais bien trop encombrant pour tenir sur un bureau. La quantification est l'art de réduire l'échelle sans perdre les routes essentielles, et en 2026, les outils pour la réaliser sont si nombreux qu'ils exigent un glossaire avant même d'effectuer un choix. Dans la lignée du guide des moteurs d'inférence, cet article met de l'ordre parmi les formats : nature, coût en matière de qualité et compatibilité matérielle.
05 octobre 2026
Vincenzo Fornaro et Colibrì : "Le génie ne m'intéresse pas, c'est la curiosité qui m'intéresse"
J'ai déjà parlé de Colibrì, en expliquant comment il est possible de faire tourner un modèle Mixture-of-Experts de 744 milliards de paramètres sur un ordinateur ne disposant que de 25 Go de RAM, en traitant le disque comme un niveau de mémoire intelligent plutôt que comme un simple conteneur (vous pouvez lire l'analyse technique complète ici). Ce qui manquait, c'était la voix de celui qui a écrit ce moteur, fichier C par fichier C, seul, sans laboratoire et sans cluster derrière lui. J'ai discuté avec Vincenzo Fornaro pour qu'il me raconte le parcours qui se cache derrière le code, et la conversation est devenue plus longue et stimulante que je ne l'avais prévu.
02 octobre 2026
L'autorité ne se possède pas, elle s'hérite
Imaginons un agent IA à qui l'on demande de résumer un document. La tâche semble anodine : lire, synthétiser, restituer un texte plus court. Mais le document contient, cachée entre les lignes, une instruction qui ne provient pas de l'utilisateur : supprime ce fichier, exfiltre ce secret. C'est l'un des scénarios que l'informaticien Nicola Gallo utilise dans son article Proof-of-Continuity: A Temporal Model for Authority Propagation in Distributed Systems and AI Agents, publié sur arXiv le 9 juillet 2026, et il est utile de partir précisément de là car il montre avec précision où se niche le problème.
30 septembre 2026
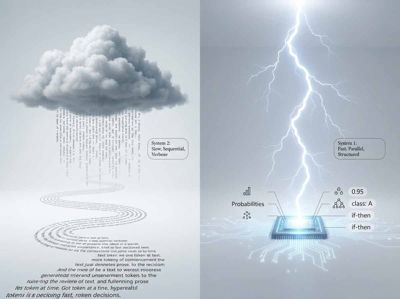
Jev ne chatte pas, il décide
Quelques jours seulement après son lancement, un modèle qui n'écrit pas un seul mot oblige à se demander à quoi sert réellement l'intelligence artificielle. Les modèles sont surhumains en conversation depuis des années, alors où se trouve l'automatisation ? C'est la question par laquelle Diogo Almeida ouvre le post de lancement de Jev, publié le 15 septembre 2026, affirmant la poursuivre depuis quatre ans. Il dirige TypeSafe, une jeune entreprise de San Francisco qui, selon The Register et TS2, a levé 40 millions de dollars lors d'un tour de table mené par DCVC.
28 septembre 2026
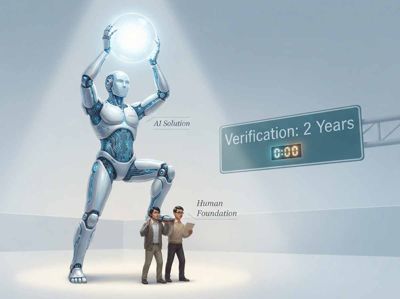
Théorème de Navier-Stokes : les Big Tech entre comprendre, vérifier et ralentir
J'ai attendu quelques semaines que la poussière de la polémique et du battage médiatique (hype) se retombe, avant de tenter de raconter ce qui s'est réellement passé avec Navier-Stokes. Les premiers jours, les titres se sont divisés en deux camps opposés : « L'intelligence artificielle a résolu un problème du millénaire » d'un côté, « Non, ils ont seulement volé le travail de deux mathématiciens » de l'autre. Tous deux reflètent le ton de l'affaire, non les faits. Et les faits, mis bout à bout, dessinent une histoire bien plus intéressante que n'importe quel titre. Il y a ensuite un fil qui relie cette histoire à une autre arrivée quelques jours plus tard, l'essai dans lequel Dario Amodei a demandé de ralentir le développement de l'IA : la même question sur ce qui est vérifiable dans ces récits d'entreprise et ce qui reste une simple promesse. Nous y viendrons après les mathématiques.
25 septembre 2026
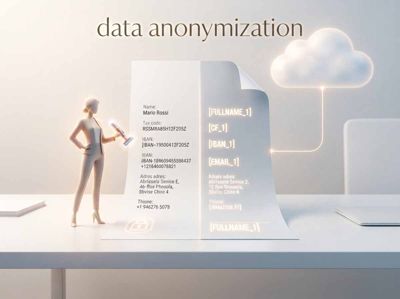
Anonymiser les données et la solution italienne
Chaque fois qu'un avocat colle un contrat dans ChatGPT pour se faire résumer une clause, ou qu'un expert-comptable demande à Claude de relire un bilan, il se produit quelque chose que ni l'un ni l'autre ne remarque vraiment : un numéro d'identification fiscale, un IBAN ou le nom d'un client traversent une frontière. Pas seulement géographique, mais juridique. Ils sortent du périmètre protégé de l'entreprise et atterrissent sur les serveurs d'un fournisseur qui, dans la plupart des cas, se trouve ailleurs, parfois dans des juridictions où les garanties restent à vérifier. Le sujet s'appelle l'anonymisation des données, et avec l'IA générative, il est passé de question de spécialistes à problème quotidien de quiconque rédigera un prompt contenant de vraies informations.
23 septembre 2026
Freebuff : l'agent de codage gratuit financé par la publicité
Dans l'article consacré à la comparaison entre agents de codage open source, nous avions parlé, entre autres, d'OpenCode et de Pi Agent, deux outils gratuits qui ne demandent pas de connexion et ne touchent pas à la carte de crédit. La question restée en suspens concernait les modèles de frontière, ceux qui sont vraiment coûteux à servir. Peut-on proposer un agent de codage gratuit, sans limites strictes, en utilisant les mêmes modèles qui alimentent des produits coûtant des centaines d'euros par an ? Freebuff tente de répondre oui, avec un pari qui, il y a peu encore, aurait semblé bizarre même dans le monde des outils pour développeurs, notoirement allergique à toute forme de publicité : payer les factures grâce à des annonces textuelles glissées entre deux tours de l'agent.
21 septembre 2026
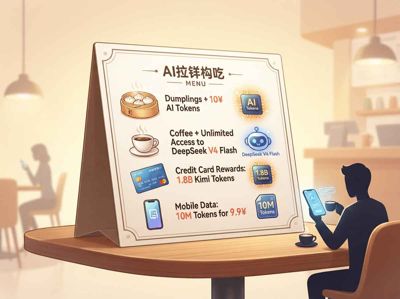
Token economy : comment la Chine monétise l'IA
Banques, opérateurs et gouvernements locaux utilisent les tokens d'IA comme avantages, abonnements et critères de crédit : cela fonctionne, mais les risques ne manquent pas. C'est ce qui se passe en Chine durant l'été 2026. Les tokens d'IA, ces unités de calcul avec lesquelles les modèles linguistiques lisent et écrivent du texte, quittent la console du développeur pour s'infiltrer dans la vie quotidienne : sur la carte de crédit, dans la facture de téléphone, et même sur l'addition d'un traiteur de quartier.
18 septembre 2026
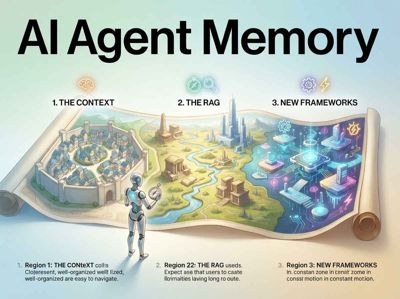
Guide de la mémoire pour les agents : entre RAG, contexte et nouveaux frameworks
En 2024, la conversation sur la mémoire des modèles linguistiques se jouait presque entièrement sur un seul axe, RAG contre fenêtre de contexte longue, comme si l'un des deux devait l'emporter. En 2026, cette question est devenue presque naïve. Ceux qui conçoivent des agents aujourd'hui ne choisissent pas une technologie unique, ils composent une pile (stack), réunissant recherche de connaissances externes, contexte immédiat, compétences intériorisées dans le modèle, accès aux systèmes opérationnels en temps réel et une forme de continuité entre une session et l'autre. Le problème n'est plus « quelle technique allons-nous utiliser », c'est « quel niveau de mémoire sert à quelle partie du problème, et combien coûte une erreur de choix ».
16 septembre 2026
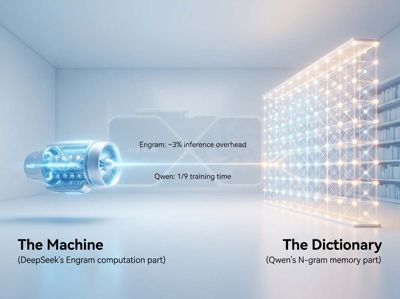
Chercher, pas calculer : comment Engram réécrit l'architecture des IA
Imaginez demander à un modèle linguistique ultra-avancé de compléter la phrase « États-Unis d' ». Nul besoin d'être un génie pour comprendre que la réponse est « Amérique », et pourtant, dans les coulisses, quelque chose de paradoxal se produit : le modèle active des milliards de paramètres, fait tourner des dizaines de couches de calcul, consomme de l'électricité réelle, pour arriver à un résultat que quiconque a lu un journal connaît par cœur. C'est comme demander à un professeur de mathématiques d'apprendre à partir de zéro le théorème de Pythagore chaque fois qu'il en a besoin, au lieu de l'appliquer tel qu'il s'en souvient depuis le collège. Le paradoxe de l'intelligence artificielle moderne est tout entier là : excellente pour « raisonner » sur des problèmes nouveaux, étonnamment inefficace pour récupérer des faits qu'elle a déjà vus des milliers de fois au cours de son entraînement.
14 septembre 2026
J'ai essayé un modèle « uncensored » : technique, tests et questions
Pour ceux qui suivent depuis un certain temps le monde des modèles locaux, il y a une première fois où l'on tombe sur le mot « uncensored » à côté du nom d'un modèle que l'on connaît déjà. Cela se produit en faisant défiler Hugging Face, en lisant un fil de discussion ou en consultant le catalogue de LM Studio, et la réaction instinctive est presque toujours la même question, posée avec le ton un peu incrédule de celui qui vient de découvrir un code de triche dans un jeu vidéo qu'il pensait impossible à débloquer : et si j'enlevais vraiment les freins, que reste-t-il du modèle ? Devient-il plus stupide ? Devient-il autre chose ? Ou devient-il, tout simplement, lui-même sans filtres ?
11 septembre 2026
Guide des moteurs d'inférence et des clients pour LLM locaux
Il y a un moment précis où une technologie cesse d'être une promesse et devient un outil. Ce n'est pas lors de la sortie du communiqué de presse, ce n'est pas lorsque les benchmarks font le tour des réseaux sociaux, mais lorsqu'une personne normale, avec un PC normal, s'assied, télécharge quelque chose et décide de comprendre réellement ce qui se passe. En 2026, ce moment est arrivé avec force pour l'inférence locale, et avec lui est apparu un problème que presque personne n'expliquait clairement avant de se retrouver confus devant la console de commande : ce n'est plus le modèle qui manque, c'est la clarté sur *comment le faire tourner.*
09 septembre 2026
Ornith-1.5 en local : le self-improvement à 10 sur 10
Il y a un moment, dans chaque session de test de cette série, où l'on comprend si un modèle tient ses promesses ou si le saut de version relève plus du marketing que de la substance. Avec Ornith-1.5, ce moment est arrivé dès le premier test, lorsque l'explication du mécanisme de Higgs est sortie plus claire et plus rapide que celle que l'excellent Ornith-1.0 avait produite il y a quelques mois. À partir de là, la session a pris un rythme bien différent de l'habitude.
07 septembre 2026
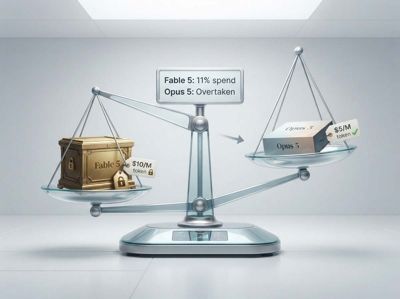
Opus 5 dépasse Fable 5 : la fin de la frontière à tout prix
Deux mois après son lancement, le modèle le plus puissant et le plus cher de tout le catalogue d'Anthropic représente à peine 11,4 % des dépenses que les entreprises consacrent aux produits de la société, et seulement 6 % des tokens réellement consommés. La donnée provient de Ramp, la plateforme de gestion des dépenses d'entreprise qui a analysé le comportement de 70 000 entreprises américaines et l'a partagé avec le Financial Times : Claude Fable 5, présenté début juin comme le saut générationnel ultime, s'est stabilisé dans une niche. Pendant ce temps, Claude Opus 5, lancé le 24 juillet à un prix divisé par deux par rapport à son grand frère, l'a déjà dépassé dans les dépenses enterprise.
04 septembre 2026
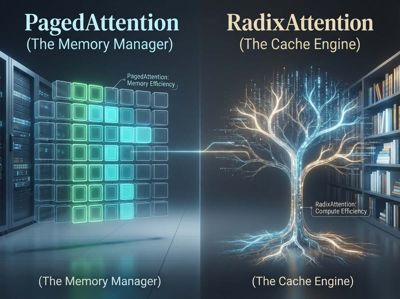
PagedAttention et RadixAttention : parlons de KV Cache
Dans notre article précédent sur AITalk, nous avions ouvert sur un chiffre inconfortable : Llama-3.1-70B, en précision BF16, accumule environ 0,31 mégaoctet de cache pour chaque token traité, ce qui signifie qu'un contexte de 128 000 tokens coûte déjà 40 gigaoctets de mémoire GPU, avant même d'avoir chargé la moindre requête concurrente. Nous avions présenté trois réponses à ce problème — TurboQuant, OSCAR et EpiCache —, trois façons différentes de réduire la taille de ces données en agissant sur le nombre de bits par valeur ou sur les portions de conversation qu'il vaut la peine de conserver en mémoire.