
Ultimi Articoli dal mondo dell'Intelligenza Artificiale
07 ottobre 2026
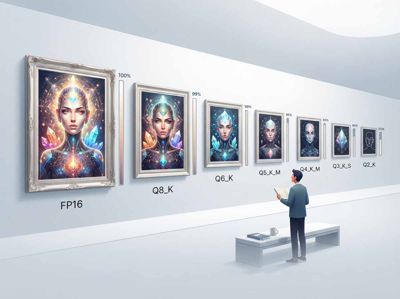
Guida ai formati di quantizzazione per LLM locali
Nell'apologo di Borges sull'impero e la sua mappa, i cartografi arrivano a disegnare una carta grande quanto il territorio e scoprono che non serve a niente. Un modello linguistico a 16 bit è quella mappa: fedelissima, in scala uno a uno, troppo ingombrante per stare sulla scrivania. La quantizzazione è l'arte di ridurre la scala senza perdere le strade che contano, e nel 2026 gli strumenti per farlo sono così tanti da richiedere un glossario prima ancora di scegliere. Dopo la guida ai motori di inferenza, questo pezzo mette ordine tra i formati: cosa sono, quanto costano in qualità, con quale hardware convengono.
05 ottobre 2026
Vincenzo Fornaro e Colibrì: "Non mi interessa il genio, mi interessa la curiosità"
Di Colibrì ho già parlato, raccontando com'è possibile far girare un modello Mixture-of-Experts da 744 miliardi di parametri su un computer con appena 25 GB di RAM, trattando il disco come un livello di memoria intelligente invece che come un semplice contenitore (potete leggere l'analisi tecnica completa qui). Quello che mancava era la voce di chi quel motore lo ha scritto, un file C alla volta, da solo, senza laboratorio e senza cluster alle spalle. Ho chiacchierato con Vincenzo Fornaro per farmi raccontare il percorso che sta dietro al codice, e la conversazione, è diventata lunga e stimolante più di quanto avessi previsto.
02 ottobre 2026
L'autorità non si possiede, si eredita
Immaginiamo un agente AI a cui viene chiesto di riassumere un documento. Il compito sembra innocuo: leggere, sintetizzare, restituire un testo più breve. Ma il documento contiene, nascosta tra le righe, un'istruzione che non viene dall'utente: cancella questo file, esfiltra quel segreto. È uno degli scenari che l'informatico Nicola Gallo usa nel suo paper Proof-of-Continuity: A Temporal Model for Authority Propagation in Distributed Systems and AI Agents, pubblicato su arXiv il 9 luglio 2026, ed è utile partire proprio da lì perché mostra con precisione dove si annida il problema.
30 settembre 2026
Jev non chatta, decide
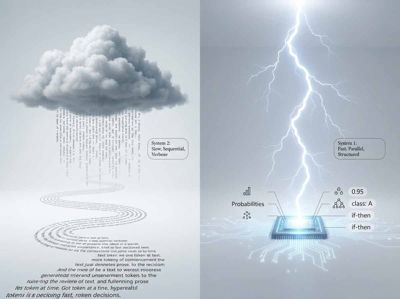
A pochi giorni dal lancio, un modello che non scrive una sola parola costringe a chiedersi a cosa serva davvero l'intelligenza artificiale. I modelli sono sovrumani in chat da anni, quindi dov'è l'automazione? È la domanda con cui Diogo Almeida apre il post di lancio di Jev, pubblicato il 15 settembre 2026, e dice di rincorrerla da quattro anni. Guida TypeSafe, giovane azienda di San Francisco che, secondo The Register e TS2, ha raccolto 40 milioni di dollari in un round guidato da DCVC.
28 settembre 2026
Teorema Navier-Stokes: big tech tra capire, verificare e rallentare
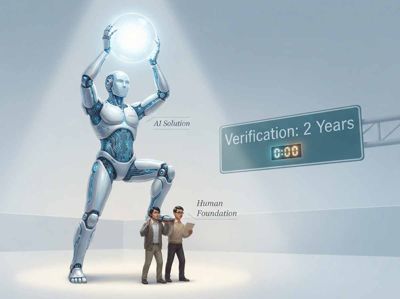
Ho aspettato qualche settimana perché si posasse la polvere della polemica e dell'hype, prima di provare a raccontare cosa è successo davvero con Navier-Stokes. Nei primi giorni i titoli si sono divisi in due partiti opposti, "l'intelligenza artificiale ha risolto un problema del millennio" da una parte, "no, hanno solo rubato il lavoro di due matematici" dall'altra. Entrambi raccontano il tono della vicenda, non i fatti. E i fatti, messi in fila, disegnano una storia più interessante di qualunque titolo. C'è poi un filo che lega questa storia a un'altra arrivata pochi giorni dopo, il saggio con cui Dario Amodei ha chiesto di rallentare lo sviluppo dell'AI: stessa domanda, cosa di questi racconti aziendali è verificabile e cosa resta promessa. Ci arriveremo dopo la matematica.
25 settembre 2026
Anonimizzare i dati e la soluzione italiana
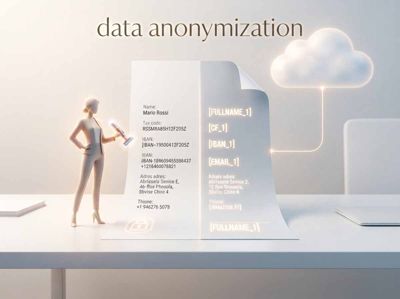
Ogni volta che un avvocato incolla un contratto in ChatGPT per farsi riassumere una clausola, o un commercialista chiede a Claude di rileggere un bilancio, succede qualcosa che nessuno dei due nota davvero: un codice fiscale, un IBAN, il nome di un cliente attraversano un confine. Non geografico soltanto, ma giuridico. Escono dal perimetro protetto dell'azienda e finiscono sui server di un fornitore che, nella maggior parte dei casi, sta altrove, a volte in giurisdizioni dove le garanzie sono tutte da verificare. Il tema si chiama anonimizzazione dei dati, e con l'AI generativa è passato da questione per addetti ai lavori a problema quotidiano di chiunque scriva un prompt con dentro informazioni vere.
23 settembre 2026
Freebuff: il coding agent gratuito con la pubblicità
Nel pezzo dedicato al confronto tra agenti di coding open source avevamo raccontato, tra gli altri, di OpenCode e Pi Agent, due strumenti gratuiti che non chiedono login e non toccano la carta di credito. La domanda che era rimasta in sospeso riguardava i modelli di frontiera, quelli davvero costosi da servire. Si può offrire un agente di coding gratuito, senza limiti stringenti, usando gli stessi modelli che alimentano i prodotti da centinaia di euro l'anno? Freebuff prova a rispondere di sì, con una scommessa che fino a poco tempo fa sarebbe sembrata bizzarra persino nel mondo dei developer tool, notoriamente allergico a qualsiasi forma di pubblicità: pagare i conti con annunci testuali infilati tra un turno e l'altro dell'agente.
21 settembre 2026
Token economy: così la Cina monetizza l'AI
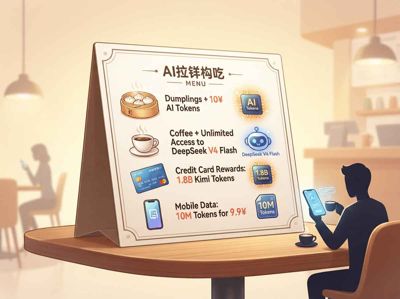
Banche, operatori e governi locali usano i token AI come benefit, abbonamenti e criterio di credito, funziona, ma i rischi non mancano. E' quello che sta succedendo in Cina nell'estate del 2026. I token AI, le unità di calcolo con cui i modelli linguistici leggono e scrivono testo, stanno lasciando la console dello sviluppatore per infilarsi nella vita di tutti i giorni: nella carta di credito, nella bolletta del telefono, perfino nel conto di una gastronomia di quartiere.
18 settembre 2026
Guida alla memoria per gli agenti: tra RAG, contesto e nuovi framework
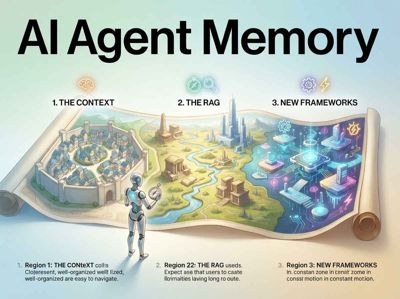
Nel 2024 la conversazione sulla memoria dei modelli linguistici si giocava quasi tutta su un asse solo, RAG contro finestra di contesto lunga, come se dovesse vincere uno dei due. Nel 2026 quella domanda è diventata quasi ingenua. Chi progetta agenti oggi non sceglie una tecnologia, compone uno stack, mettendo insieme recupero di conoscenza esterna, contesto immediato, competenze interiorizzate nel modello, accesso a sistemi operativi in tempo reale e una qualche forma di continuità tra una sessione e l'altra. Il problema non è più "quale tecnica useremo", è "quale livello di memoria serve a quale pezzo del problema, e quanto costa sbagliare la scelta".
16 settembre 2026
Cercare, non calcolare: come Engram sta riscrivendo l'architettura delle AI
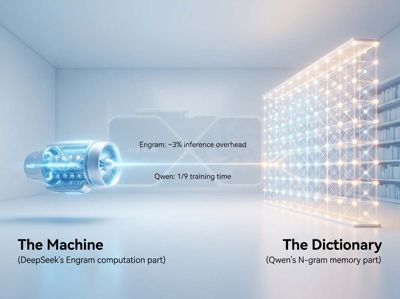
Immaginate di chiedere a un modello linguistico avanzatissimo di completare la frase "Stati Uniti d'". Non serve un genio per capire che la risposta è "America", eppure dietro le quinte succede qualcosa di paradossale: il modello attiva miliardi di parametri, fa girare decine di layer di calcolo, consuma energia elettrica vera, per arrivare a un risultato che chiunque abbia letto un giornale conosce a memoria. È come chiedere a un professore di matematica di imparare da zero il teorema di Pitagora ogni volta che gli serve, invece di applicarlo come lo ricorda dalle scuole medie. Il paradosso dell'intelligenza artificiale moderna è tutto qui: eccellente nel 'ragionare' su problemi nuovi, sorprendentemente inefficiente nel recuperare fatti che ha già visto migliaia di volte durante l'addestramento.
14 settembre 2026
Ho provato un modello "uncensored": tecnica, test, e domande
Per chi segue da un po' il mondo dei modelli locali, c'è una prima volta in cui ci si imbatte nella parola "uncensored" accanto al nome di un modello che si conosce già. Succede scorrendo Hugging Face, leggendo un thread o consultando il catalogo di LM Studio, e la reazione istintiva è quasi sempre la stessa domanda, posta con il tono un po' incredulo di chi ha appena scoperto un trucco di un videogioco che pensava impossibile da sbloccare: e se togliessi davvero i freni, cosa resta del modello? Diventa più stupido? Diventa un'altra cosa? O diventa, semplicemente, se stesso senza filtri?
11 settembre 2026
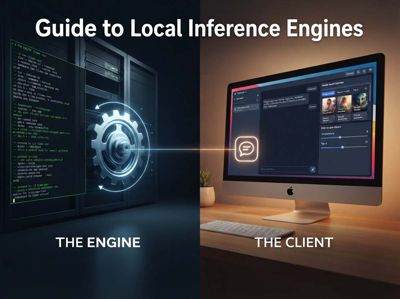
Guida ai motori di inferenza e ai client per LLM locali
C'è un momento preciso in cui una tecnologia smette di essere promessa e diventa strumento. Non è quando esce il comunicato stampa, non è quando i benchmark fanno il giro dei social, ma quando una persona normale, con un PC normale, si siede, scarica qualcosa e decide di capire davvero cosa sta succedendo. Nel 2026 questo momento è arrivato con forza per l'inferenza locale, e con essa si è aperto un problema che quasi nessuno spiegava chiaramente prima di arrivare confuso davanti alla console di comando: non manca più il modello, manca la chiarezza su *come farlo girare.*
09 settembre 2026
Ornith-1.5 in locale: il self-improvement da 10 su 10
C'è un momento, in ogni sessione di test di questa serie, in cui capisci se un modello mantiene le promesse o se il salto di versione è più marketing che sostanza. Con Ornith-1.5 quel momento è arrivato già al primo test, quando la spiegazione del meccanismo di Higgs è uscita più chiara e più veloce di quella che il pur ottimo Ornith-1.0 aveva prodotto mesi fa. Da lì la sessione ha preso un ritmo diverso dal solito.
07 settembre 2026
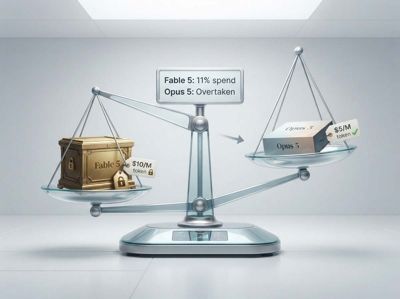
Opus 5 supera Fable 5: La fine della frontiera a tutti i costi
Due mesi dopo il lancio, il modello più potente e più caro dell'intero catalogo Anthropic vale appena l'11,4% della spesa che le aziende destinano ai prodotti dell'azienda, e solo il 6% dei token effettivamente consumati. Il dato arriva da Ramp, la piattaforma di gestione spese che ha analizzato il comportamento di 70.000 aziende statunitensi e lo ha condiviso con il Financial Times: Claude Fable 5, presentato a inizio giugno come il salto generazionale definitivo, si è fermato a una nicchia. Nel frattempo Claude Opus 5, lanciato il 24 luglio a un prezzo dimezzato rispetto al fratello maggiore, lo ha già superato nella spesa enterprise.
04 settembre 2026
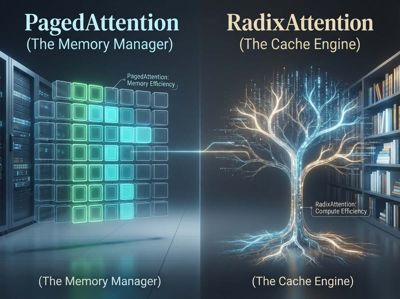
PagedAttention e RadixAttention, parliamo di KV Cache
Nel pezzo precedente su AITalk avevamo aperto con un numero scomodo: Llama-3.1-70B, in precisione BF16, accumula circa 0,31 megabyte di cache per ogni token elaborato, il che significa che un contesto di 128.000 token costa già 40 gigabyte di memoria GPU, prima ancora di aver caricato una singola richiesta concorrente. Avevamo raccontato tre risposte a questo problema, TurboQuant, OSCAR ed EpiCache, tre modi diversi di rendere quei dati più piccoli, agendo sul numero di bit per valore o su quali porzioni di conversazione vale la pena tenere in memoria.